用一条箭头开启的插件
有些扩展既不是工具也不是指令——它们改变的是智能体的 shell 打印什么、智能体怎样回答。NeuroSquad 0.1.160 把它们称为插件:画上箭头,从下一条命令起生效;移除箭头,随即停止。
在此之前,NeuroSquad 画布上的一条箭头能交给智能体两类东西:MCP 服务器,也就是工具;以及技能,也就是在任务匹配时加载的指令。但有些有用的扩展两者都不是。它们不增加能力,而是改变智能体的工作方式——它的 shell 命令在模型读取之前打印多少内容,或者它回答时要花多少字。
NeuroSquad 0.1.160 给了它们一个自己的位置:插件,与 MCP 服务器和技能并列的第三个目录。插件就是一张卡片。从智能体画一条箭头到它,插件就开启;移除箭头,插件就关闭,两者都不需要重启。首批两个插件是 RTK-AI Token Saver 和 Caveman。
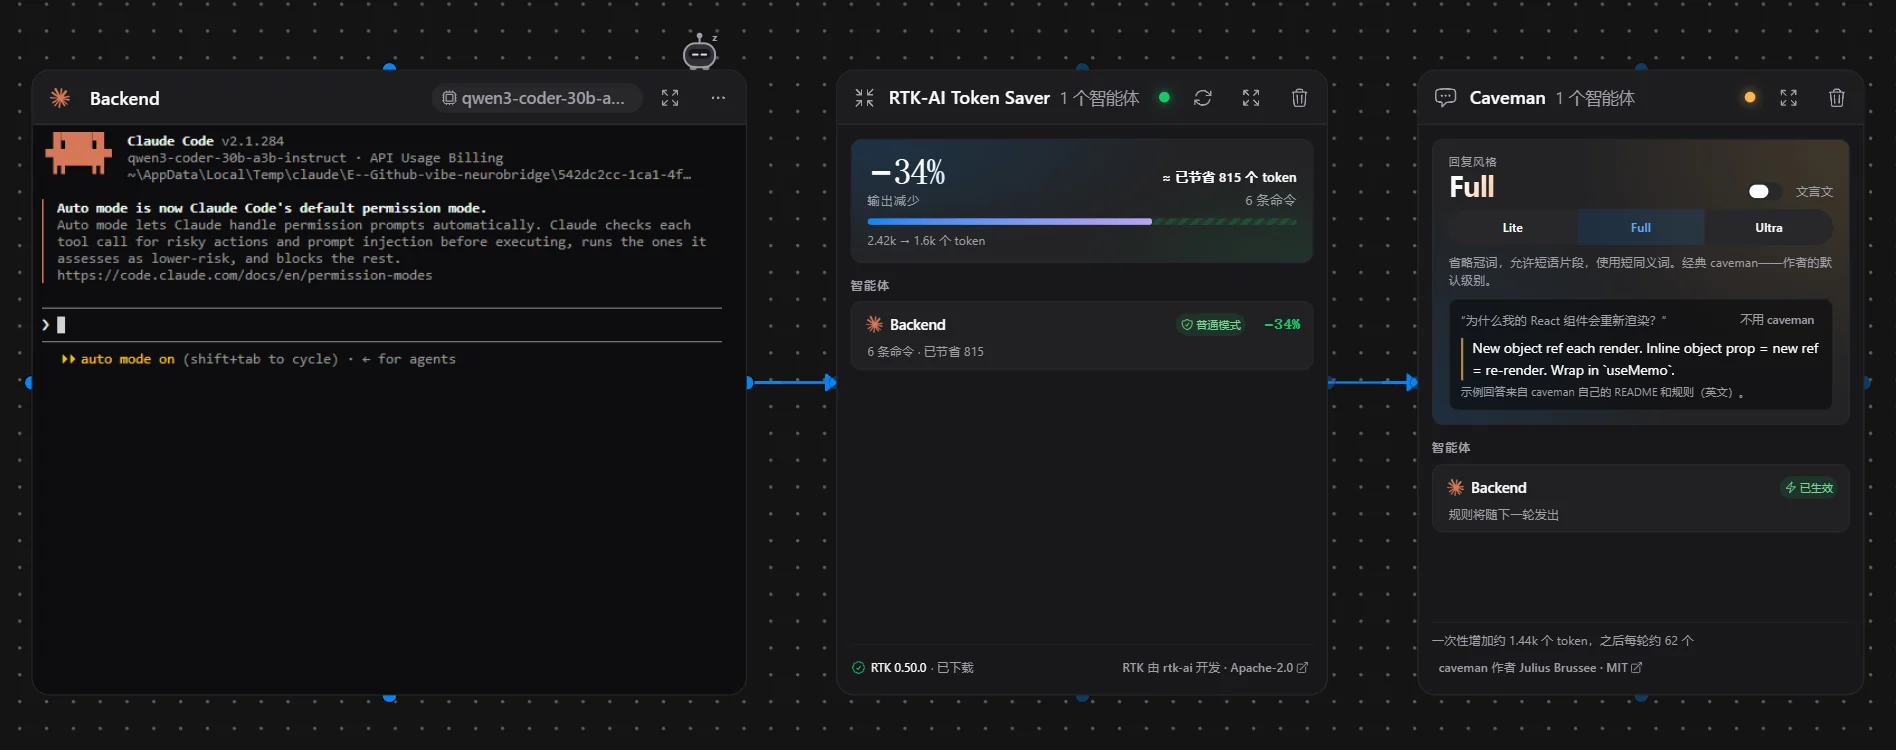
插件如何实时生效
每张智能体卡片本来就会带着钩子(hook)启动它的 CLI,这些钩子指向应用内部的一个小服务器,只监听本机回环地址。卡片正是靠它们知道智能体在工作、在等你,还是已经完成。CLI 会在固定时刻调用这些钩子——执行 shell 命令之前、你提交提示词时——而在此之前,应用的回答总是“没有意见”。
插件改变的就是这个回答。每次调用时,应用都会看一眼箭头:没有箭头,什么都不变;有箭头,回答里就带上插件的那一部分。由于 CLI 每次都会询问,开关在紧接着的下一条命令或下一轮就会生效。你的 CLI 自身的设置里不会写入任何东西,也不会往 CLI 里安装任何东西。
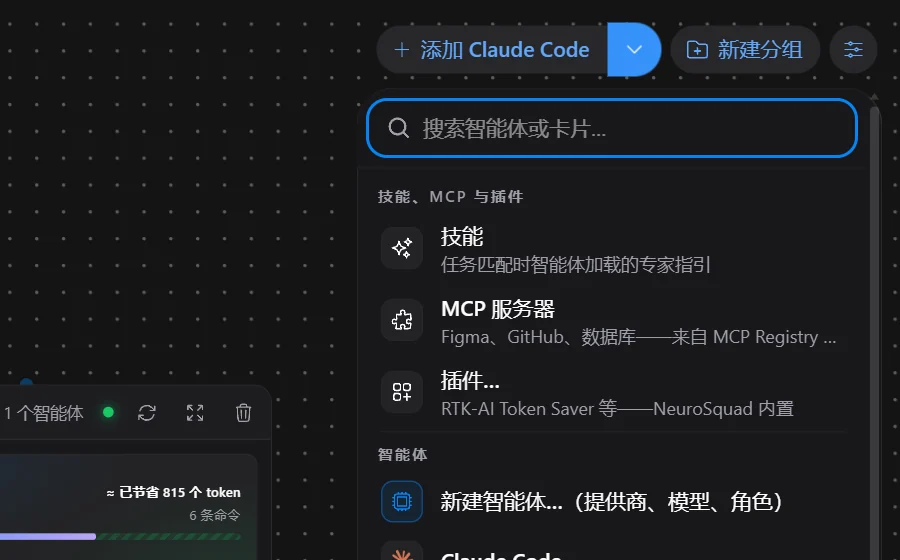
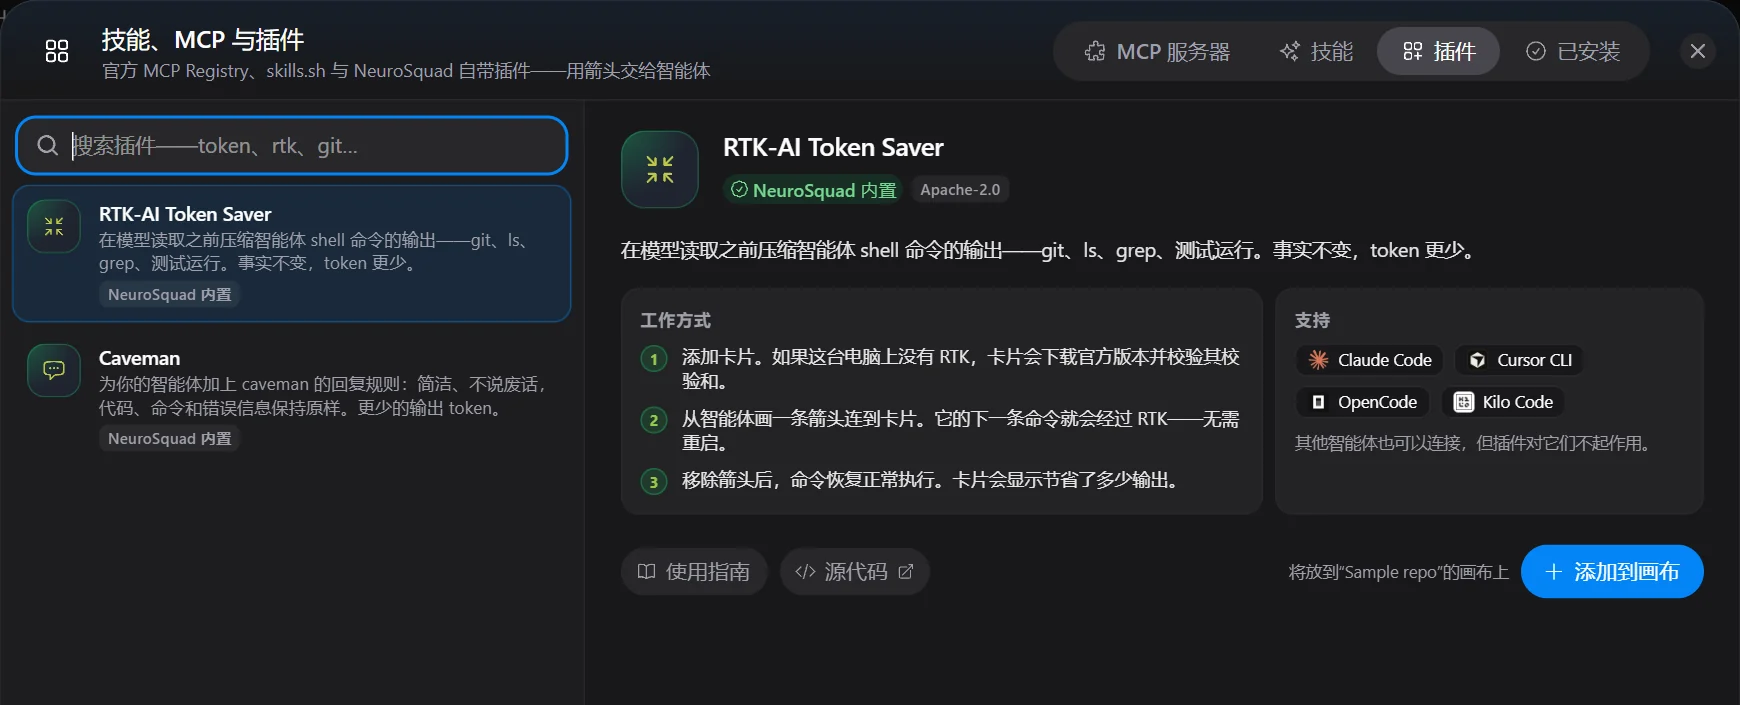
RTK-AI Token Saver
RTK 是一个开源命令行工具(Apache-2.0)。它运行 git、ls、grep、测试运行器和许多其他命令,并打印压缩后的输出:分组、去重,在真正重要的地方只保留失败项。哪些命令它能处理,由它自己的 rtk rewrite 来决定。
智能体有箭头连到这张卡片时,它的命令前钩子会在每条 shell 命令之前询问应用,应用再询问 RTK,于是 git status 以 rtk git status 的形式运行。只有 shell 命令会受影响——Claude Code 自己读取文件和搜索的工具不是 shell 调用,保持原样。如果 RTK 不存在或出错,就运行原始命令。
这些是一次测试运行的数字,而且因命令而差异很大:同一次运行中,git log -n 3 缩短了 18%,而 git log --stat 和一次小范围的 grep 一点也没省下。卡片不承诺任何数字;它显示的是每个已连接智能体的真实节省量,RTK 会为每个智能体单独记录在一个数据库里。
途中的发现:不增加任何权限确认
第一个版本会改写它能改写的每条命令。在 Claude Code 的普通模式下测试时,问题暴露了:Claude 是拿改写后的命令去对照它的权限规则,以及它内置的只读命令自动批准。git status 不经询问就运行了,rtk git status 却要求确认。一个会增加确认弹窗的省 token 工具,还不如没有。
所以在普通模式下,改写遵循一张决策表。你自己的允许规则已经覆盖的命令:改写并允许。刻意保持很短的只读清单上的命令——单独一条 git status、log、diff 或 show,列出分支,ls、cat、head、tail、wc、grep、rg 或 find,所有路径都在项目内,没有会写入或执行任何东西的参数——改写并允许,因为 Claude 本来也会自动放行。本来就会询问的命令仍然询问,而且和以前一样只问一次。其他一切保持不动。用同样的七条命令测试:不用 RTK 时有两次确认,用 RTK 时仍是同样的两次。在危险模式下,RTK 会改写它能处理的一切。Cursor CLI、OpenCode 和 Kilo Code 只在危险模式下使用 RTK,因为它们的批准决定取决于应用看不到的规则。
Caveman
Julius Brussee 的 caveman 是一套回答规则,采用 MIT 许可:不寒暄、不含糊其辞、不复述刚做过的事——同时代码、命令、文件路径和错误信息一字不改,安全警告仍用完整的句子。插件原样附带这些规则,提供 caveman 的 Lite、Full、Ultra 三个级别以及文言文变体。
有箭头时,智能体的提示词钩子会把规则加到它的下一轮:完整文本每个会话只发一次,之后每一轮附上 caveman 自己的一行提醒。移除箭头,智能体会收到一条恢复正常回答的说明。它在 Claude Code、Codex 和 Qwen Code 中实时生效。
它到底能省多少——实话实说
我们做了一次演示:Claude Code 配 Haiku 4.5,在同一个会话里问三个相似的问题,第二个问题前画上箭头,第三个问题前移除。回答从没有箭头时的 225 个英文单词(1,506 个字符),变为有箭头时的 159 个单词(1,164 个字符),移除后又回到 254 个单词(1,706 个字符)。
计费的输出几乎没变:413、408 和 419 个 token。服务商把模型的思考过程也算作输出,而 caveman 并不会缩短思考。caveman 的作者也这样说,并列出了它吃亏的场景:规则本身在每次调用时都是额外的输入——按我们的估算,一次约 1,440 个 token,此后每轮约 62 个——在很短的问题上,它的花费可能比省下的还多。所以 Caveman 卡片不显示任何节省数字,只显示开启了什么、对哪些智能体开启,以及规则本身的成本。
caveman 的仓库里还有一个本地代理,用来压缩智能体读取的内容。我们没有把它内置进来。它的引擎源码公开,但所用的许可不允许在另一个产品中提供它;而且它位于通往模型的流量之中,订阅登录会经过它——而 NeuroSquad 从不读取或代理 CLI 的凭据。
自有模型服务器
“设置 → 提供商”新增了一节 你的提供方:LM Studio、Ollama、Unsloth Studio、llama.cpp、vLLM,或任何支持 OpenAI 或 Anthropic API 的远程服务器。你不需要选择 API。测试连接 会读取模型列表,并向 chat、Responses 和 Messages 端点各发一个空请求,因此不会加载任何模型;只有测试通过后才能保存提供方。
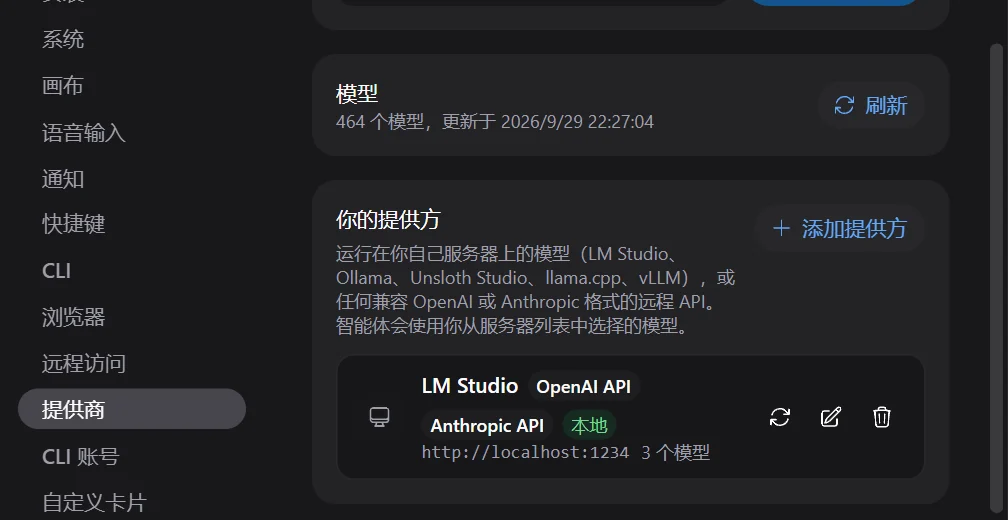
只要服务器上有某个 CLI 需要的 API,该 CLI 就会提供这个提供方:Claude Code 需要 Anthropic API,Codex 需要 OpenAI Responses API,其余大多数两者皆可——一共十五个 CLI。Cursor、Amp 和 Auggie 不行:它们的模型只在各自厂商的服务器上运行。如果服务器需要密钥,密钥由操作系统加密,只通过环境变量交给智能体。测试时我们发现一件事:完全没有密钥时,Claude Code 会退回到你自己的 Anthropic 登录,并把那个令牌发给本地服务器。所以应用总会改为发送一个占位密钥。
无需重启的危险模式
过去 Claude Code 卡片的危险模式是一个启动参数,而这个参数在会话中途无法撤回。现在每张 Claude 卡片都有一个钩子,Claude 只会在即将弹出权限对话框时调用它。危险模式开启时,应用回答“允许”;关闭时,对话框照常出现。无论打开还是关闭,都会在同一个会话里对下一次批准生效。实测:touch 先请求了权限,打开开关后不再询问直接运行,关闭后又重新询问。其他 CLI 仍在启动时读取危险模式;它们的卡片现在提供 立即重启,并保留对话。
告诉我们还缺什么
账号菜单中的“提交想法”和“报告问题”会打开 app.neurosquad.ai 上新的“想法”和“问题”板块,应用版本和操作系统已经自动填好。
插件页面:RTK-AI Token Saver 和 Caveman;完整的变更列表见 0.1.160 更新日志。