代码图谱与 Context7:让智能体去查证,而不是去猜
智能体常常把一轮又一轮花在 grep 上,而这些问题本可以直接问;写代码时用的库 API 也是模型记忆中的样子。NeuroSquad 0.1.230 为此带来两个插件:代码图谱——你代码的地图;Context7——今天的文档。
看看智能体在一个陌生仓库里是怎么工作的。为了回答“谁调用了这个函数?”,它用 grep 搜名字,打开一个文件,换个模式再搜,又打开两个文件——每一步都是单独的一轮,每读一个文件都占用上下文。接着它按某个库写代码,用的 API 却是模型从训练数据里记住的样子,可能比你 package.json 里的版本落后一两个大版本。
NeuroSquad 0.1.230 针对这两个习惯加入了两张插件卡片。代码图谱维护工作区代码的知识图谱,智能体直接查询它,不用再在文件里翻找。Context7 为智能体即将使用的库取来对应版本的最新文档。和所有插件一样,它们都是画布上的卡片,从智能体画过去的箭头决定它能不能用。
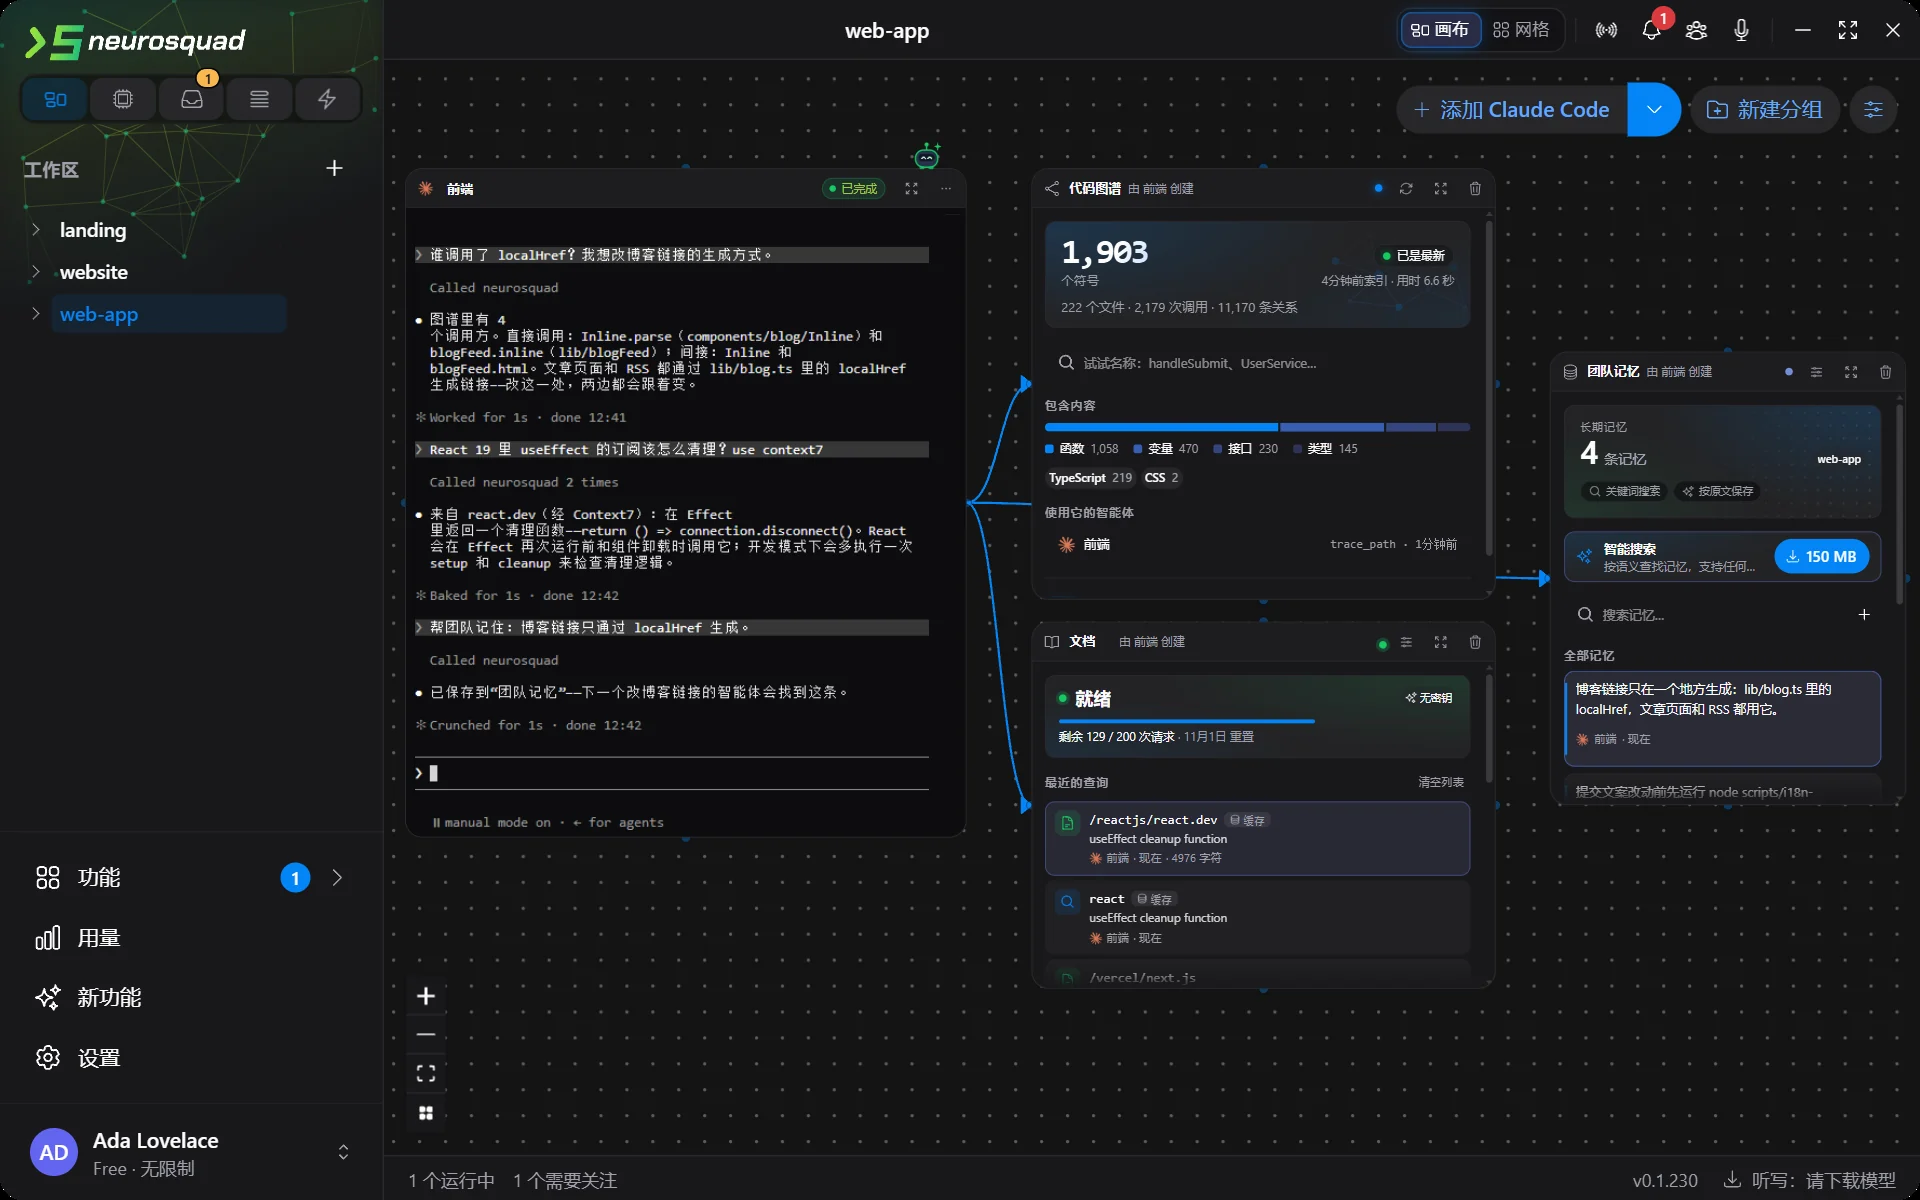
localHref 的调用方来自图谱,清理规则来自经 Context7 取得的 react.dev,最后为下一个智能体留下一条笔记。截图中的智能体连接的是脚本化的本地模型;图谱、Context7 的回答和记忆都来自真实的应用。用代码地图代替 grep
代码图谱基于 codebase-memory-mcp,这是一个开源(MIT)引擎,用 tree-sitter 解析项目,把找到的内容——函数、类、变量、调用、导入、路由——存成一张图。从智能体向卡片画一条箭头,智能体就获得 12 个工具:codegraph_search_graph 按名称或含义查找符号,codegraph_trace_path 追踪调用方和被调用方,还有 codegraph_get_code_snippet、codegraph_get_architecture、只读图查询 codegraph_query_graph 等,一直到 codegraph_reindex。“谁调用了 localHref?”这样的问题只需一次调用,就能得到通向它的四个函数,其中两个是直接调用——而不是一连串 grep。
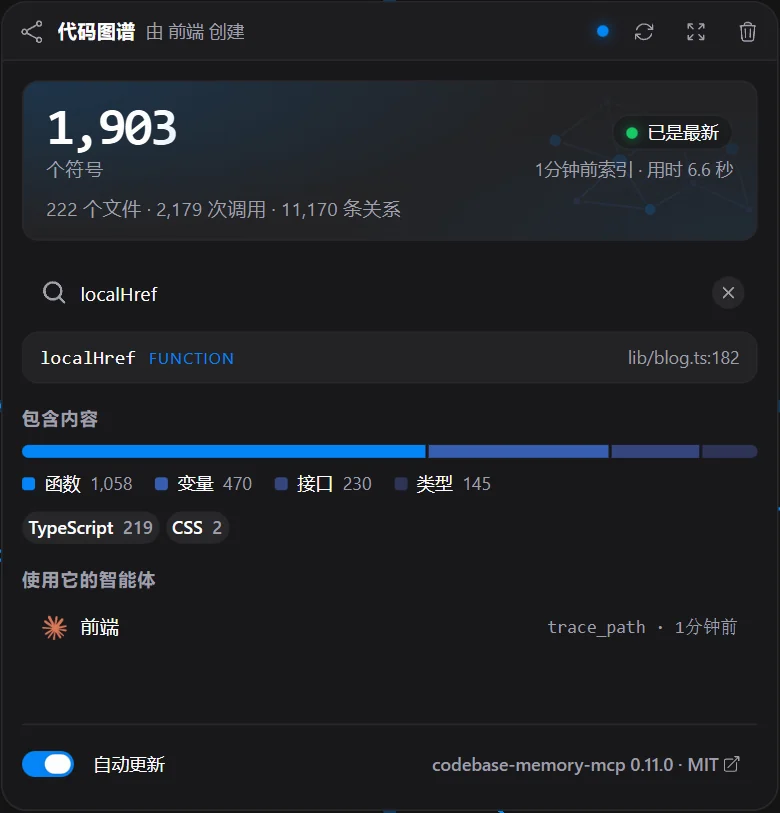
为了截图,我们索引了自家落地页代码的一份副本:222 个 TypeScript 文件,1,903 个符号,2,179 次调用。在这台机器上,首次构建用了 29 秒(包括引擎启动),之后的重新索引用了 6.6 秒。卡片会显示这些数字、代码的构成、按名称搜索,以及哪个智能体调用了哪个工具。
无需提醒,自动保持最新
落后于代码的图谱比没有更糟,所以卡片会自己保持它最新。它监视文件夹,在最后一次改动几秒后重新索引;已过时的图谱还会在已连接的智能体结束一轮时刷新,并且每次启动应用后刷新一次,以防应用关闭期间文件有变动。如果查询恰好赶上更新,回答里会注明。关闭自动更新后,卡片会显示“文件有变动”和“立即更新”按钮。
代价是什么
引擎是每个平台一个独立的程序。卡片只下载一次——约 40 MB,解压后约 300 MB——并在运行前与应用中固定的 SHA-256 校验。它在你的电脑上运行,无需账号,没有遥测,代码不会离开本机。索引放在应用的数据文件夹里:不会往你的仓库或主目录写任何东西,我们在运行前后都核对过这两处。
今天的文档,而不是训练时的记忆
Upstash 的 Context7 为大量开源库的文档建立索引,并返回与问题匹配的片段。卡片为智能体提供它的两个工具:context7_resolve_library_id 把“react”这样的名称转换为库 ID,context7_query_docs 返回该库与问题对应的片段,每段都附有来源链接。Context7 以需要 Node 的 MCP 服务器形式发布;应用则自己发出同样的两个请求,所以无需安装任何东西,也不会多一个进程。
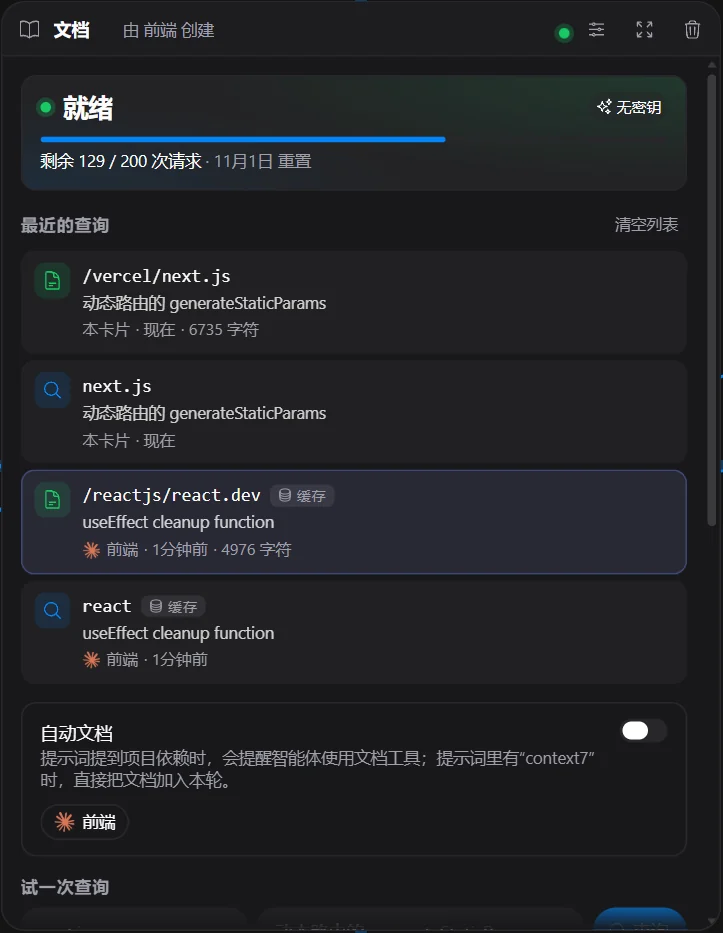
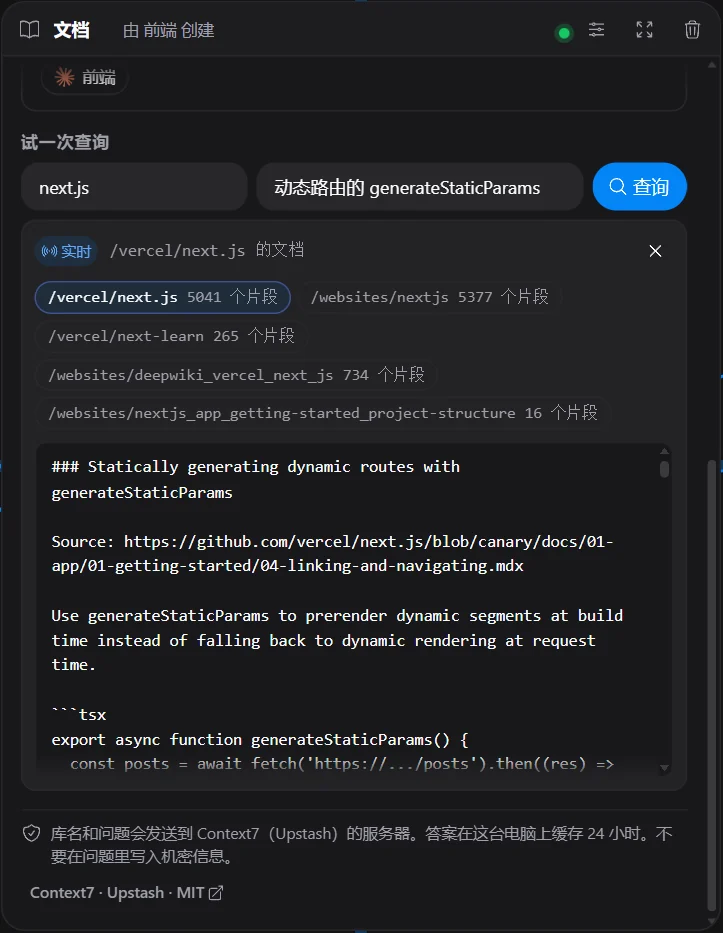
回答会在你的电脑上缓存 24 小时,所以第二个智能体问同样的问题不消耗额度,同时发出的相同请求也只取一次。卡片底部的试一次查询可以手动做同样的搜索:输入库名和问题,看到匹配的库以及最佳匹配的文档。
自动文档是卡片上的一个开关,默认关闭,它让智能体不必自己记着去查。当提示里提到项目的某个依赖——读取自 package.json、requirements.txt、pyproject.toml、Cargo.toml 或 go.mod——智能体的这一轮会得到一条简短提示,指向文档工具并带上你声明的版本。如果提示里还写了“context7”,在时间来得及时会直接附上文档。提示不会仅仅因为提到某个库就被发送给 Context7:那样会在没人要求时消耗每月的额度。
限制,说清楚
- 不用密钥每月 200 次请求。 Context7 的匿名额度按 IP 地址计算,所以同一网络里的其他工具也会占用它。额度用完时,卡片会说明,工具在重置之前不再发送请求——陷入循环的智能体也不会让情况更糟——缓存中的回答照常可用。免费的 Context7 密钥可以提高额度;它加密保存,只放在请求头里发送。
- 哪些内容会离开你的电脑。 库名和问题会发送到 Context7 的服务器。你的代码不会,但不要在问题里写机密信息。卡片在查询框下方也写明了这一点。
箭头说了算
两个插件都遵循画布上所有卡片的规则:箭头就是权限。画上箭头,智能体就获得这些工具——大多数命令行智能体无需重启就能识别。去掉箭头,工具随之消失。Codex、Kimi Code、Cursor 和 Crush 只在启动时读取一次工具列表,所以对它们来说工具始终列出,调用能否通过由箭头决定。两个插件适用于 NeuroSquad 中所有支持 MCP 的命令行智能体。截图里的智能体还连着上一版加入的记忆插件,把刚学到的内容留给下一个智能体。
在 WSL 和 SSH 中
从 0.1.214 起,工作区可以位于 WSL 发行版或 SSH 主机上。代码图谱需要读取文件,所以在这种工作区里,引擎就在代码所在的地方运行。在 x86-64 或 ARM64 的 Linux 上,卡片会在首次索引时把经过校验的压缩包复制过去——约 40 MB,而不是解压后的引擎——在那一端再次校验哈希,然后解压到那台机器上应用自己的文件夹里,索引也放在那里。那台机器上的主目录和仓库不会被改动,退出应用时引擎随之停止。对于运行 macOS 的主机,卡片会显示“此主机没有引擎版本”。
位于 Windows 磁盘上的 WSL 文件夹照常被监视。在发行版自己的磁盘上和通过 SSH 时,没有低成本的文件事件,所以图谱会在已连接智能体结束一轮时以及按需刷新。记忆和 Context7 在另一台机器上什么都不需要:它们在你电脑上的应用里运行,像其他工具一样通过箭头为 WSL 或 SSH 主机上的智能体服务。自动文档会读取那台机器上的项目清单文件。
每个插件都有自己的页面——代码图谱、Context7 和记忆——文档中也有使用指南:代码图谱和 Context7。完整的变更列表见 0.1.230 更新日志。